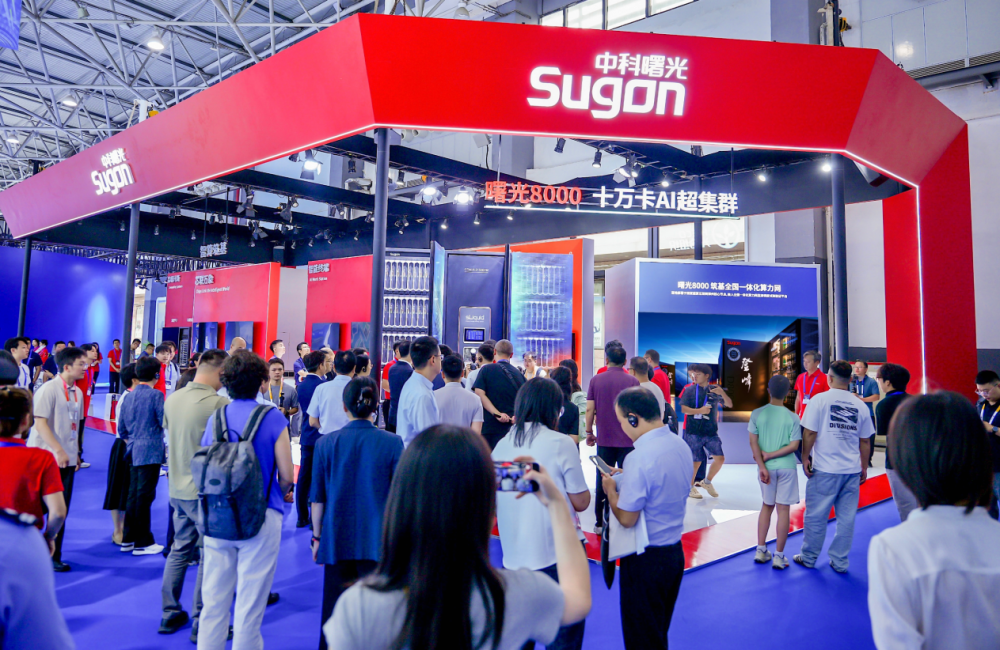
8月28日,2026中国国际大数据产业博览会期间,中科曙光推出新一代词元加速方案ParaCache。这项技术通过保存并复用大模型已计算结果,让重复计算减少80%以上。实测显示,处理约12万词元输入时,模型开始回答前的等待时间最高可降98.5%;高并发场景下,系统每秒处理词元量达原值27倍。
现在大模型要处理长文本、多轮对话、知识库问答等复杂场景,相同内容被反复计算。这不仅让等待时间拉长,还浪费大量算力资源。ParaCache的解决思路很直接:把算过的结果保存下来,下次直接调用。
这项技术整合GPU显存、CPU内存、固态硬盘和分布式存储,根据使用频率分层存放计算结果。支持跨请求、跨节点共享,实现"一次计算、多次使用"。基于曙光分布式存储ParaStor和集中式全闪存储FlashNexus,让存储能力从保存原始数据延伸到复用计算结果,既减少重复计算,又降低显存占用。
ParaCache带来四重价值:高并发下处理速度提升27倍,单轮对话等待时间降至0.4秒,连续20轮对话时间由43秒缩短至5秒。兼容主流推理框架和国产AI加速卡,可直接接入现有系统。高频内容留在显存,其他数据转移到成本更低的存储设备,大幅降低硬件依赖。
目前ParaCache已在某头部互联网企业落地,模型等待时间降低超50%。在曙光8000超集群验证通过,可支持长文本对话、智能客服等场景。中科曙光北京公司负责人表示,这项技术不是单纯提升单卡性能,而是通过减少重复计算,让算力专注处理新任务。
少一次重复计算,就少一段等待时间,也少一份算力消耗。ParaCache为数据要素价值释放提供了新路径,让计算结果的价值持续复用。