大模型推理正面临“速度与成本”的双重挑战。传统自回归推理方式需要重复计算,导致响应变慢;而为加速推理引入的KV Cache又占用大量显存,模型越大、上下文越长,硬件成本越高。当显存被“打爆”,算力再强也难以应对更多请求,这道“内存墙”正成为全球AI基础设施的共性难题。
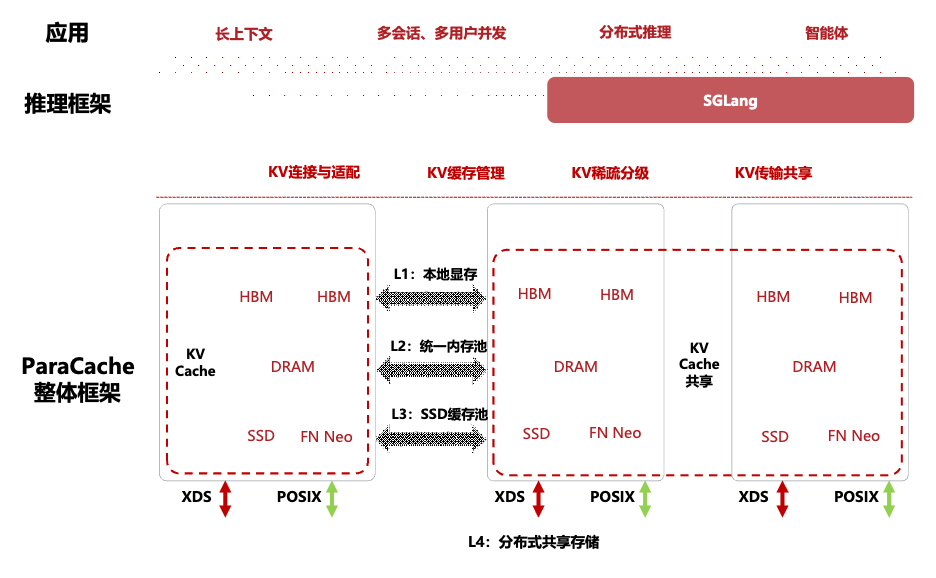
中科曙光推出的ParaCache方案通过“以存换算”思路,用存储空间换取计算节约。该方案构建分布式共享存储,在硬件层面跨芯片调度计算,打通GPU HBM、CPU DRAM、SSD等多个存储层级。运行层面则跨请求复用KV张量,实现周/月/年级别的数据复用,让存力真正成为算力的加速器。
在实际测试中,ParaCache展现出惊人效果。120K输入长度时,单轮对话首Token时延降低98.5%至400ms,多轮会话响应时间缩短超80%。高并发场景下,跨GPU构建的分布式缓存池实现“一次计算、多次复用”,集群吞吐量最高提升27倍。更关键的是,通过四级缓存体系,内存占用大幅降低,让中低配硬件也能支撑高配性能。
这套方案已在曙光8000十万卡AI超集群验证落地。通过池化管理GPU HBM、CPU DRAM、SSD和分布式存储,有效消除多节点重复数据加载开销。面对长上下文对话、重复请求等场景,ParaCache能直接调用历史缓存,仅对新增内容进行迭代计算。这种无感调度机制突破传统HBM容量限制,让超长上下文推理变得稳定可靠。
从技术角度看,ParaCache不仅是KV缓存管理方案,更是重构大模型推理架构的关键。它标志着AI基础设施从单纯算力堆砌转向存算协同,推动存储从数据容器进化为智能调度中枢。这种创新让大模型推理真正走向生产化,为AI应用打开新空间。