后摩尔时代算力增长的重心正从"造大芯片"转向"高效组织单元"。当数据离开封装进入板卡、机柜乃至整个智算集群时,计算芯片的运算速度与数据传输速度之间的差距日益凸显。这种"通信墙"正成为制约集群算力线性扩展的关键障碍。
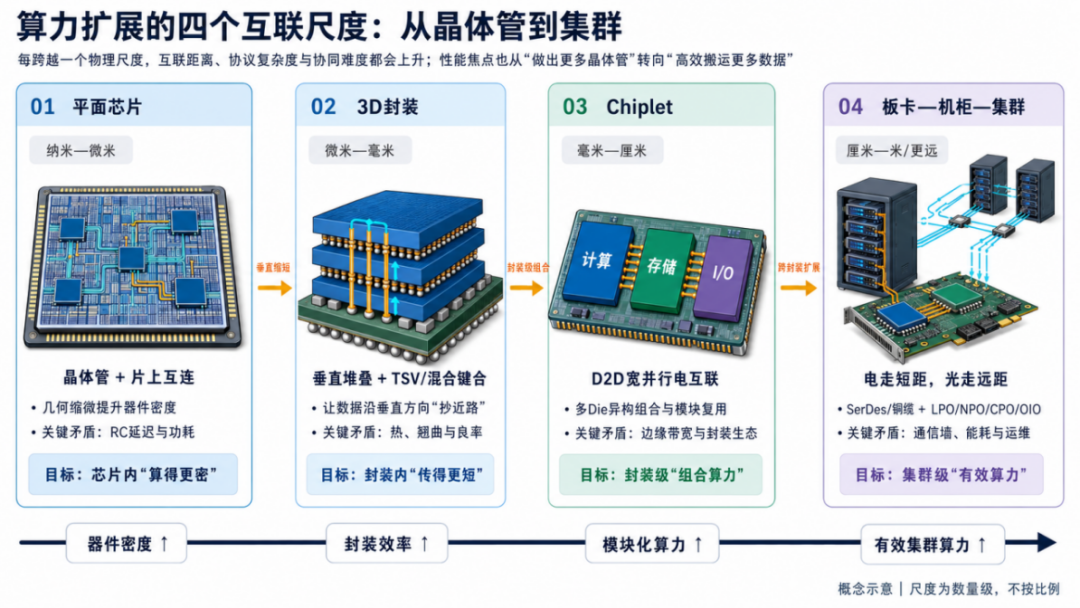
电互联仍是短距离连接的基础,但随着单通道速率从112Gbit/s迈向448Gbit/s,信号损耗、串扰和均衡功耗等问题愈发突出。与此同时,光互联正沿着可插拔模块、LPO/LRO到光I/O的路径不断靠近芯片。未来智算集群的主线不是"光进铜退"的单向替代,而是根据距离、带宽密度、能耗等参数进行光电分层协同。
在Scale-up架构中,本地计算单元间的带宽需求可达Scale-out链路的9倍。这意味着决定超节点效率的不仅是单颗芯片的运算能力,更取决于互联能否以足够高的带宽持续"喂饱"芯片。这种需求推动着高速电互联向"更短、更密、更靠近芯片"的方向演进,同时光互联也在向芯片边缘渗透。
从可插拔光模块到共封装光学,光互联的标准化进程正在加速。LPO/LRO、NPO、CPO等技术形态正在形成清晰的工程化框架,而OIO则仍处于前沿探索阶段。不同空间尺度下的光电协同选择矩阵显示,封装内以电为主、板级光电协同、系统级以光扩展的多层结构,可能是未来高效智算集群的标配。
真正需要争取的不是某一种接口的胜负,而是从芯片、封装、光引擎到网络的系统协同能力。只有让数据流动速度与计算能力同步增长,更多峰值算力才能转化为可持续的集群级有效算力。