Meta 官方昨日宣布推出 Muse Voice Transcribe 模型,这是其首个具备实时音频感知能力的AI系统。该模型能同步处理多人对话,支持20余名说话者分轨转写,可实时识别语音边界并输出文字。
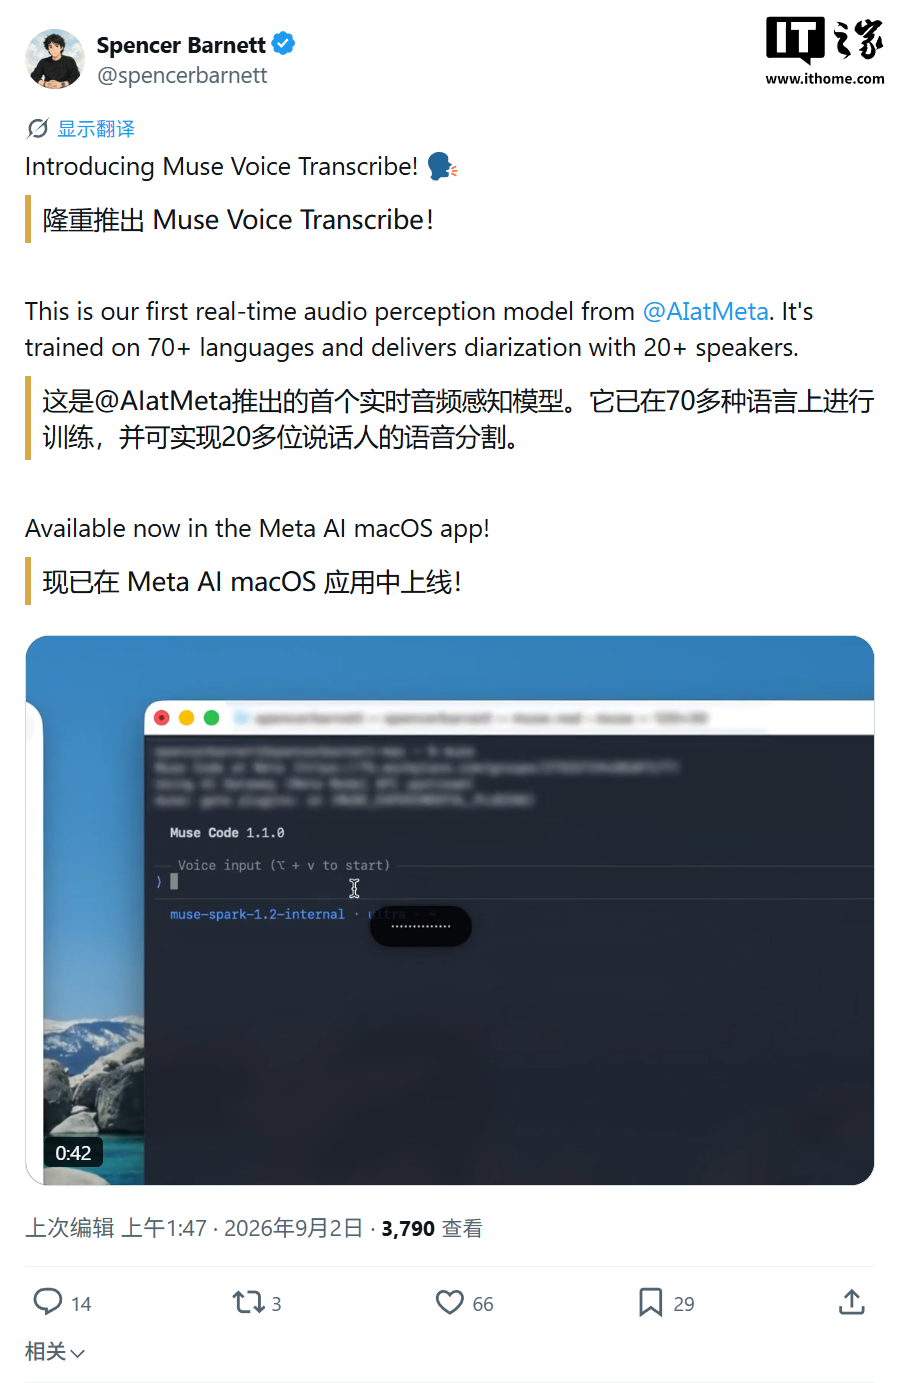
开发者可通过 Meta Model API 调用该能力,按每1000分钟3美元(约20元人民币)收费。相比传统语音识别系统,该模型在同一流程中整合了流式识别、说话人分离和端点检测三项技术,实现边说边转写。
技术亮点在于其独特的自适应延迟机制。系统会根据语音清晰度动态调整处理速度,对易识别内容快速输出,对模糊发音或复杂语境则调用更多上下文信息。这种机制既保证实时性又维持识别准确度。
模型支持70余种语言,其中25种语言已完成验证。可处理超过1小时的长音频,并支持语言切换。开发者可通过语言偏置、关键词提示等方式提升特定场景下的识别效果。目前该模型在流式语音转文本排行榜中位列第一。
这项技术将极大提升多场景下的语音处理效率,尤其适合会议记录、实时翻译等需求。随着AI语音技术的持续进化,未来或将改变更多行业的工作方式。